---
title: LM Studio 本地运行 AI 大模型:免费 API 与 Token
description: 在 Mac 上安装 LM Studio,下载 Qwen3.5、Gemma 4 等本地大模型,并把电脑变成一个局域网内可直接调用的免费大模型 API 服务。
outline: deep
category: 教程
date: 2026-11-02
tags:
- LM Studio
- 本地大模型
- API
- Mac
readingTime: 9 分钟
---
# LM Studio 本地运行 AI 大模型:免费 API 与 Token
> 📺 本图文教程由视频整理而成,对应的参考视频:[本地运行AI大模型~LM Studio让你拥有免费API和Token~](https://www.bilibili.com/video/BV1ToL866EQB)。如需查看更详细、更具体的操作演示,可观看原视频。
> 场景:想在本地跑一个 AI 大模型,既不想按 Token 付费,也不想把对话内容发到云端。LM Studio 是一款 Windows / macOS 通用的本地大模型客户端,装好后可在本机下载运行模型,并对外提供一个兼容 OpenAI 格式的 API 地址,其它软件填上这个地址就能直接使用,相当于拥有免费的 Token。
> 提示:本教程配套的操作文档,可在[好用斋官网](https://haoyongzhai.com) → [网盘分享](https://haoyongzhai.com/netdisk)(提取码 552)中下载。
## 第一步:下载安装包
网盘分享里一共有三个文件:
1. 官网地址 —— LM Studio 官方网站
2. `LM Studio-xxx.exe` —— Windows 版本
3. `LM Studio-xxx.dmg`(含 arm64 / x64 两个包)—— macOS 版本,Apple 芯片选 arm64
也可以直接打开官网 [https://lmstudio.ai](https://lmstudio.ai),页面会自动识别当前系统并给出对应安装包;点右上角 Download 还能手动选择 Windows、macOS、Linux 以及 x86 / arm64 架构和具体版本号。
## 第二步:安装并完成首次设置
1. 双击下载好的 dmg,把 LM Studio 图标拖入「应用程序」文件夹,等待复制完成。
2. 打开 LM Studio,点击「Get Started」开始。
3. 首次启动会引导下载一个模型,这里直接选择跳过,稍后按需下载。
4. 启动选项中有两项:下方是开机自启,上方是**开启开发者模式**——建议一定要打开,后面提供 API 就靠它。
5. 进入主界面后如果提示可更新,点 Update Now 即可升级到最新版。
## 第三步:切换为简体中文
1. 点击左下角齿轮进入设置。
2. 在 General 页找到 `App Language`,下拉选择「简体中文」。
::: warning 注意
LM Studio 的汉化并不完整,切换后仍是中英混杂状态:部分菜单已翻译,部分仍是英文。整体操作逻辑简单,不必纠结语言,对照本教程即可。
:::
## 第四步:认识左侧四个栏目
| 栏目 | 作用 |
| --------------------- | ------------------------------------ |
| 聊天(Chat) | 与本机加载的模型对话 |
| 开发者(Developer) | 对外提供 API 服务,最核心的栏目 |
| 我的模型(My Models) | 查看已下载到本地的模型及默认参数调整 |
| 模型仓库(Discover) | 搜索并下载模型 |
## 第五步:在模型仓库挑选并下载模型
进入模型仓库,在搜索框输入模型名(例如 `qwen3.5`),下方即列出全部结果。挑选时重点看这几项:
1. **格式**:`GGUF` 是通用标准格式,Windows / Linux 都用它;Mac 建议优先选 `MLX` 格式,针对苹果芯片优化,速度更快。
2. **参数规模**:模型名后面的 `4B`、`9B` 是参数量,B 即 Billion(十亿)。9B 约等于 90 亿参数,参数越大越聪明,但越吃显存。
3. **量化等级**:如 `Q4_K_M`,表示 4bit 量化。同一模型 Q4 体积约 6.55 GB,Q8 约翻倍到 13 GB,16bit 再翻倍。Q4 体积小、精度损失有限,性价比最高,显存有限的机器优先选 Q4。
4. **下载量与收藏数**:数值越高说明模型越受欢迎,通常也更靠谱。
在「我的模型」里,模型名后的两个图标含义不同:眼睛图标表示支持图像输入(可上传图片识别),小锤子图标表示支持工具调用(Skills、MCP 等)。演示中下载的都是 MLX 版本:Gemma 4 4B、Qwen3.5 4B、Qwen3.5 9B。
## 第六步:加载模型并对话
1. 进入聊天栏目,点顶部下拉框选择要加载的模型,等待加载完成;右侧的弹出按钮用于卸载模型。
2. 新建一个话题即可开始对话,例如输入「你是谁」。
两个模型的实际表现差异明显:
| 模型 | 输出速度 | 特点 |
| ---------- | -------------- | -------------------------------------------------------- |
| Qwen3.5 4B | 约 31 Tokens/s | 有思考过程,简单问题也可能思考十几秒,但工具调用效果更好 |
| Gemma 4 4B | 约 24 Tokens/s | 几乎不思考,回答干脆,适合追求响应速度的轻量使用 |
如果配合小龙虾这类客户端使用,Qwen3.5 的长思考会让交互显得「不跟手」,分不清是软件慢还是模型慢;追求即时反馈就选 Gemma 4,追求工具调用质量则选 Qwen3.5。
右侧参数面板只需关注两项:
1. **温度(Temperature)**:越接近 0 越发散越低,适合让模型按事实作答;调高则更有创造性,适合写文章、写诗。
2. **惩罚机制(Penalty)**:一般设为 1.1 或 1.2,避免模型产生幻觉和重复。
其余参数保持默认即可,不清楚含义时直接问 AI 这项功能是什么、推荐值是多少。
## 第七步:在开发者模式开启本地 API
进入开发者栏目,左下选「Local Server」,可以看到服务状态为 `Running`,以及一行 `Reachable at: http://192.168.x.x:1234` —— 这就是对外提供的 API 地址,后面带复制按钮。
点「Load Model」加载要对外服务的模型。新版 LM Studio 已把聊天模型和 API 模型统一,在聊天里加载的模型会直接成为对外提供的模型,不必像旧版那样两边分别加载、分别卸载。
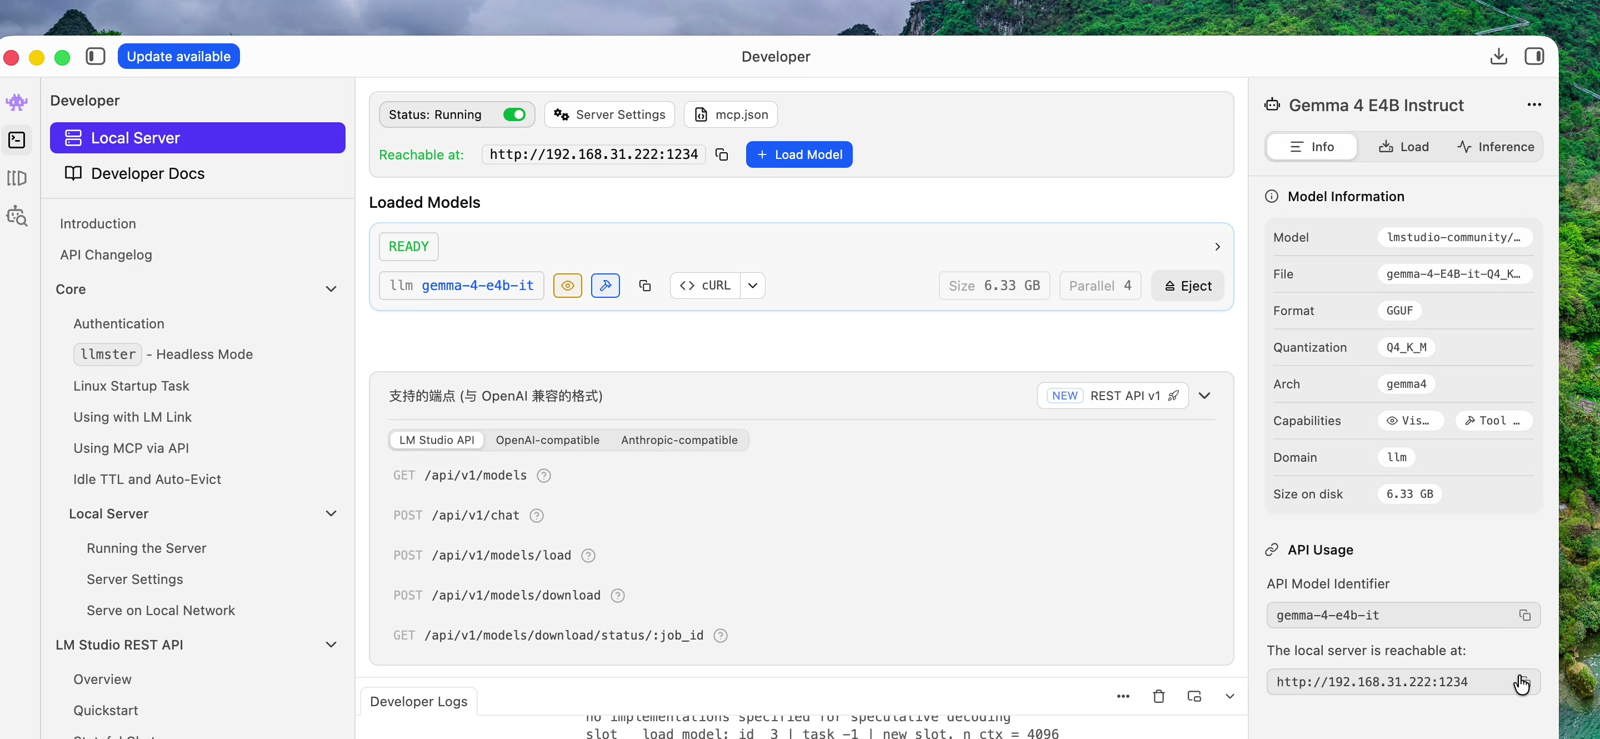 右侧面板分三块:
1. **Model Information**:模型名称、格式(GGUF / MLX)、量化等级(如 Q4_K_M)、能力标记与占用空间。
2. **API Usage**:`API Model Identifier`(如 `gemma-4-e4b-it`)和可访问地址,均可一键复制。
3. **Load / 上下文长度**:默认 4096(4K)。这一项最关键——小龙虾这类客户端最低要求 16K,实测最少给到 **32K 或 40K** 才能保证对话流畅,低于这个值几轮之后就会因上下文溢出而「忘记」前面的内容。
::: warning 注意
模型参数量和上下文长度是共同挤占内存的。演示机是 16GB 的 Mac mini M4,能跑 14B 模型(约 10 Tokens/s),但剩下给上下文的内存太少,聊几轮就开始胡说,实际不可用。宁可模型小一点,也要留足上下文。
:::
## 第八步:用 Cherry Studio 接入验证
其它程序调用本地模型,通常只需要两样东西:**API 地址(IP + 端口)** 和 **模型名称**。
1. 打开 Cherry Studio,左下角进入设置 → 模型服务,选择「LM Studio」。
2. 在 API 地址处粘贴刚才复制的 `http://192.168.x.x:1234`,点「检测」。
3. 在下方「管理」中会直接列出 LM Studio 当前可调用的模型,点加号添加需要的模型(如 `gemma-4-e4b-it`)。
4. 添加好模型之后,点击**API密钥**后面的检测,选择一个可用模型,如果提示「连接成功」即说明对接正常。
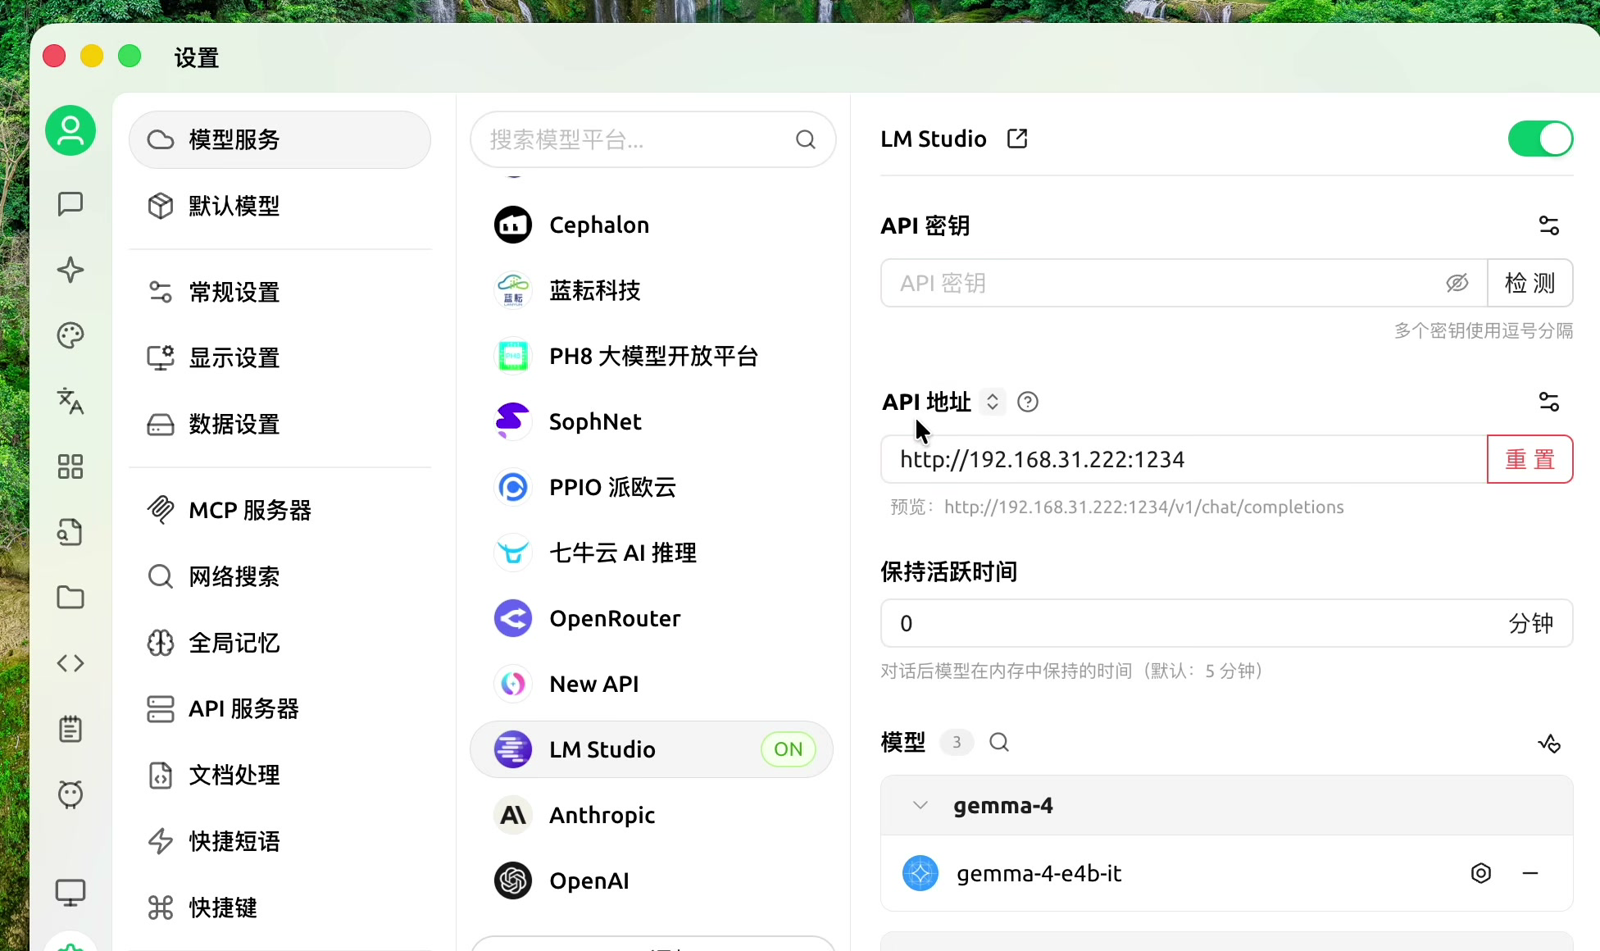 回到聊天窗口新建话题,模型选择 LM Studio 下的 Gemma 4,正常提问即可得到回答,全程不花费任何 Token。其它软件若不能自动拉取模型列表,只需把模型具体名称`API Model Identifier` 手动填进去。
## 注意事项:别把内存跑爆
跑本地模型时务必盯着内存占用。演示中已加载模型的 Mac 内存使用率已达到 87%,如果再加载更大的模型或把上下文拉得很高,确实会把内存跑爆,严重时直接导致 Mac 重启。建议:
1. 只保留当前要用的模型,不用时及时弹出模型 Eject。
2. 上下文先给 32K 起步,不够再加,不要一次拉满。
3. 用活动监视器观察内存压力,接近饱和就换更小的模型。
## 总结
LM Studio 把「下载模型 → 本地对话 → 对外提供 API」三步压缩进一个客户端里:Mac 选 MLX 格式、Q4 量化,开发者模式里复制 API 地址和模型标识,其它软件填进去即可免费使用本地大模型。Windows 版本的使用方式大同小异,只把 MLX 换成 GGUF 即可。
## 参考视频
[本地运行AI大模型~LM Studio让你拥有免费API和Token~](https://www.bilibili.com/video/BV1ToL866EQB)
## 好用斋官网
[https://haoyongzhai.com](https://haoyongzhai.com)

