零刻SER9 Pro(HX370)三个月使用体验:游戏与本地AI实测
📺 本图文教程由视频整理而成,对应的参考视频:零刻HX370小主机游戏和AI表现~3个月后的真实使用分享~。如需查看更详细、更具体的操作演示,可观看原视频。
场景:本文适合正在考虑购买 AMD HX370 平台迷你主机,或已经入手并想知道「这台小主机能玩什么游戏、能跑哪些本地大模型」的用户。本文不涉及具体安装步骤,重点是一份三个月后的真实使用结论与选型参考。
设备概况
本文测试的机器为零刻 SER9 Pro,核心配置如下:
| 项目 | 配置 |
|---|---|
| 处理器 | AMD Ryzen AI 9 HX 370 |
| 内存 | 32GB(内存与显存共用) |
| 存储 | 1TB 固态硬盘 |
| 显示器 | 32 寸 4K 60Hz |
总体结论:这台设备完全符合预期,使用体验非常满意。唯一的短板是内存偏小——尤其是涉及 AI 场景时,32GB 会明显吃紧。如果对 AI 有需求,建议64GB 起步。
第一部分:游戏表现
测试方式统一为:在 Steam 中直接以 4K 分辨率 + 默认设置启动游戏,不做任何画面参数调节。
| 游戏 | 分辨率 / 设置 | 实测帧率 | 体验评价 |
|---|---|---|---|
| 丝之歌 | 4K 默认 | 约 60 帧 | 基本稳定在 60 帧,偶尔可显示到 70+ 帧 |
| 神秘海域 4 | 4K 默认 | 约 47~48 帧 | 已完整通关,全程无问题 |
| 荒野大镖客 2 | 4K 默认 | 约 25 帧 | 帧率偏低;改用 2K 分辨率可顺利游玩 |
几点说明:
- 丝之歌的帧率上限可能受显示器 60Hz 限制,不代表机器性能上限。
- 神秘海域 4 属于老游戏,但 4K 默认设置下依然能跑到 47~48 帧,可流畅通关。
- 荒野大镖客 2 在 4K 下仅约 25 帧,降到 2K 后表现会好很多,此前实测可正常游玩。
结论:对于游戏要求不高的用户,这台小主机的性能已经足够。
第二部分:本地 AI 表现
AI 部分主要通过 LM Studio 运行本地模型,按使用场景可分为两类,二者的内存压力差别很大。
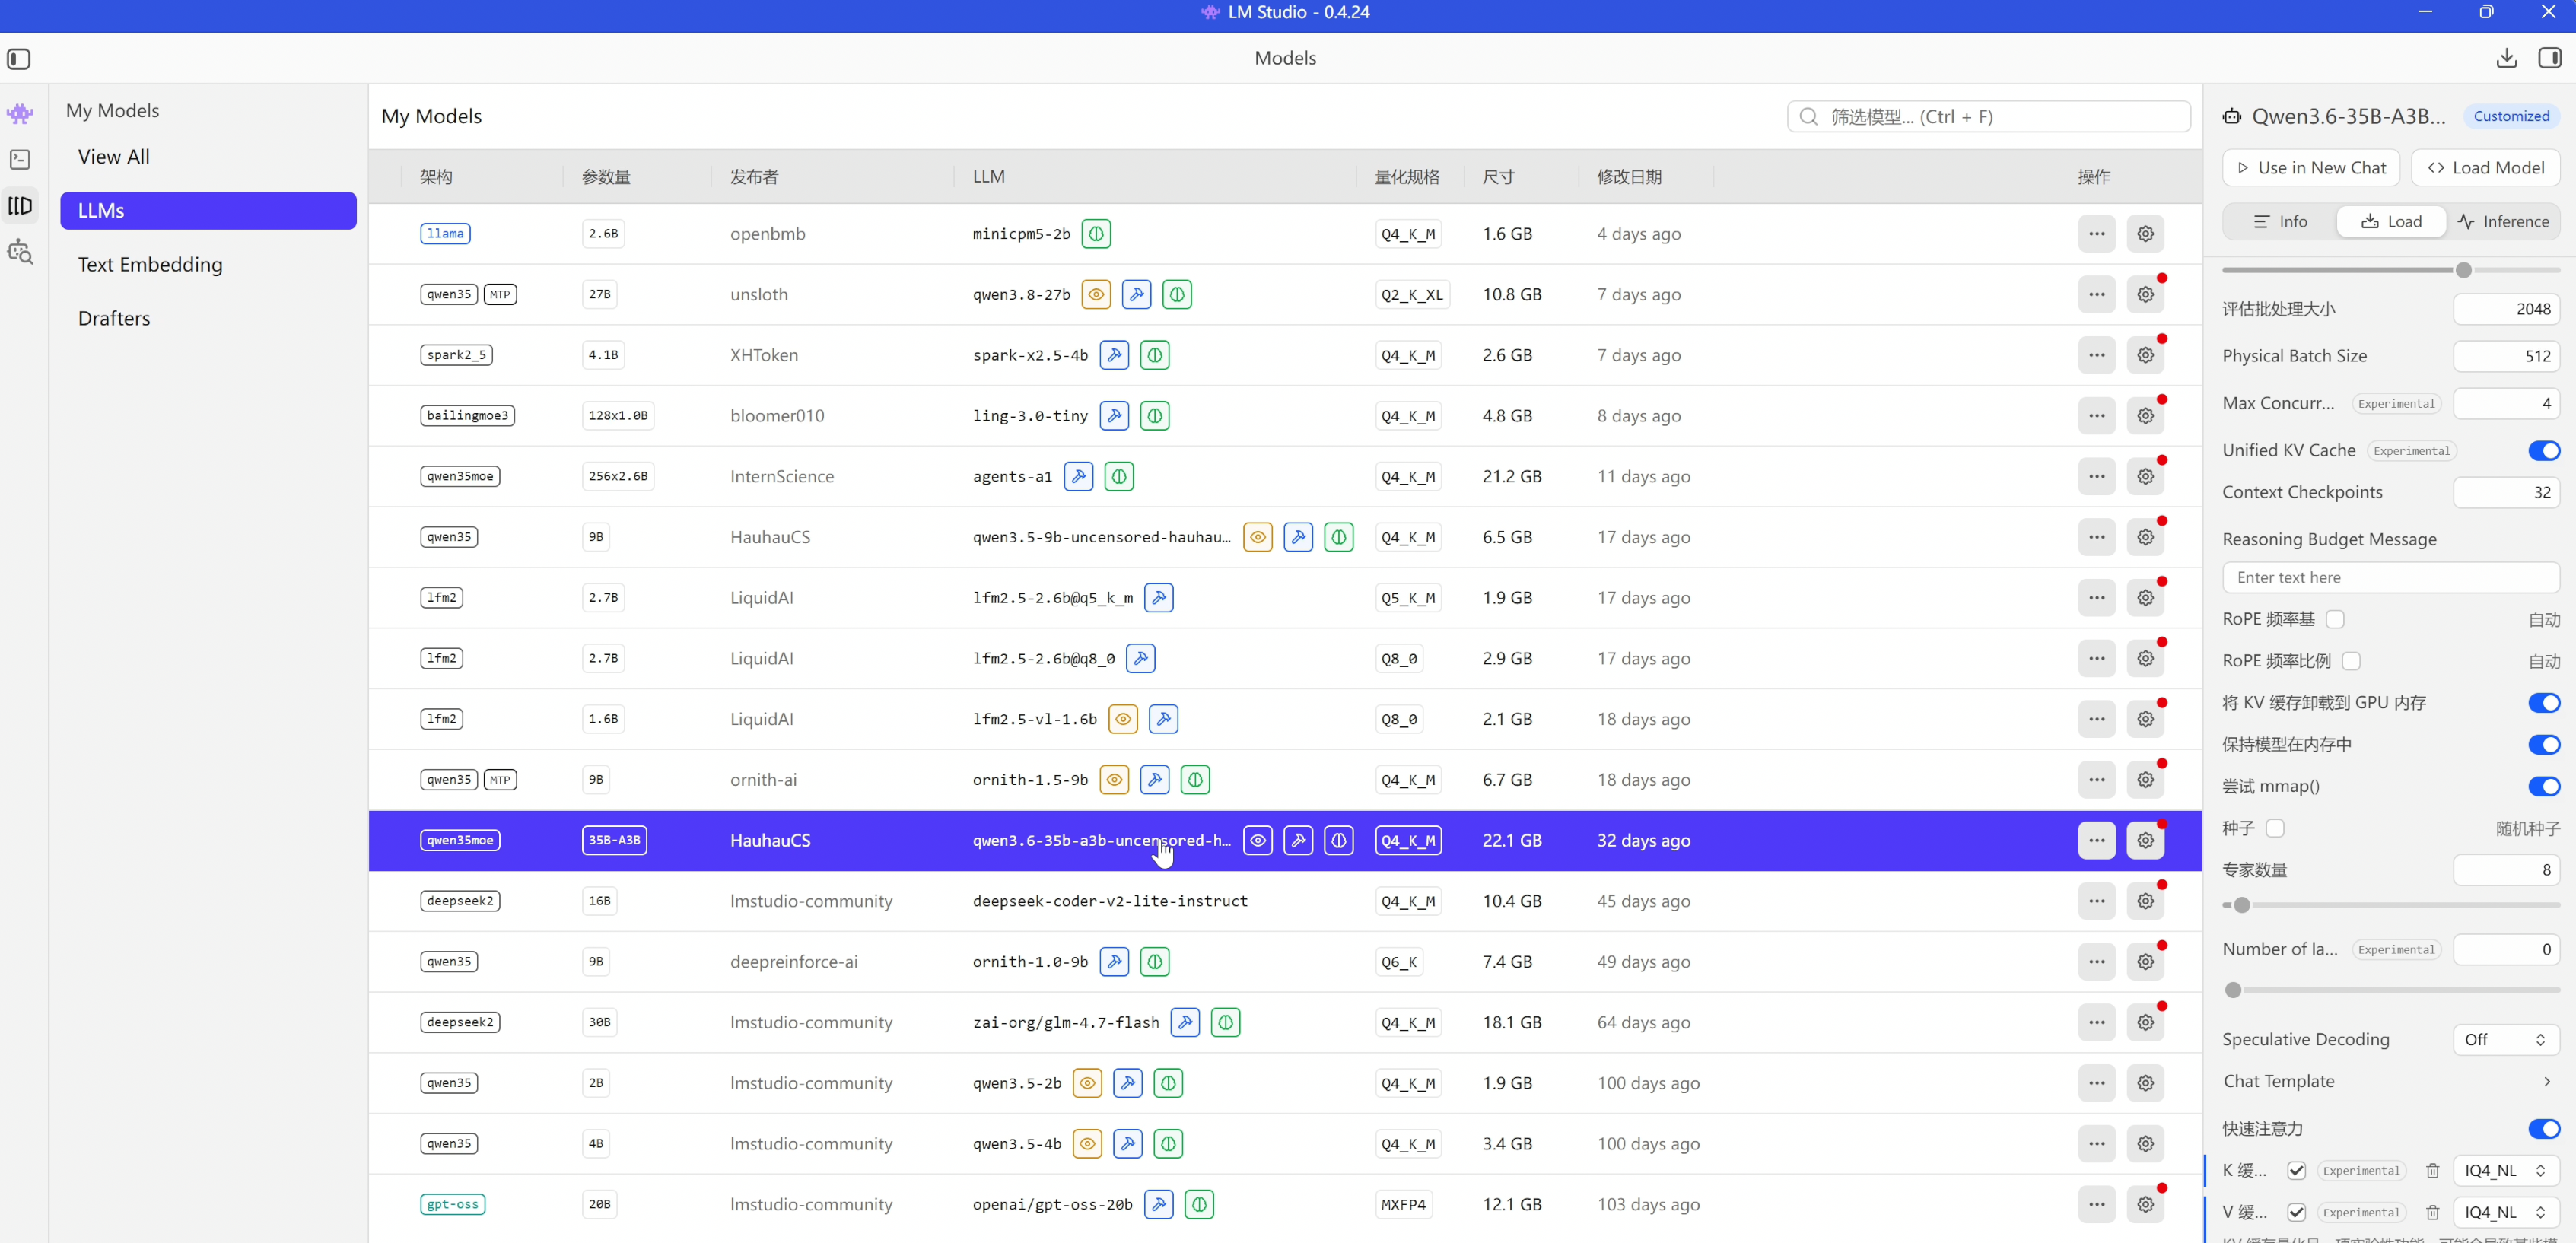
场景一:纯聊天(LM Studio 直接对话 / Cherry Studio)
这类场景的上下文注入量非常小,对上下文长度要求不严格。
- 列表中几乎所有模型都可以胜任,多轮对话也没有问题。
- 如果要做基础编程,建议选择 9B 以上的模型。
- 9B 以下的模型不要考虑——让它写个贪吃蛇都很难一次写对。
推荐的聊天模型:
| 模型 | 类型 | 特点 |
|---|---|---|
| Ornith 1.5 9B | 稠密 | 9B 档位首选,指令遵循程度好 |
| GPT OSS 20B | MoE | 均衡,接入智能体也适用 |
| QWEN 3.6 35B A3B | MoE | 智商高、速度快 |
| GLM 4.7 Flash | MoE | 智商高、速度快 |
后两个模型速度与智商表现都不错,作为聊天模型相当合适。
场景二:接入 OpenClaw / Hermes 等智能体
这是与「纯聊天」差别最大的一类场景。智能体启动时就会注入大量上下文提示词,因此对内存的要求非常严格。HX370 小主机内存与显存共用,要开大上下文时,32GB 明显不足。
以 QWEN 3.6 35B A3B 为例:
- 模型本身体积就有 22GB。
- 加载后若给16K 上下文,内存占用约到 27~28GB。
- 再叠加 Windows 自身占用,很容易爆内存。
实际采用的应对办法是给到 64K 上下文,并将 KV 缓存量化到原来的 1/4(Q4),这样才能保证不爆内存,代价就是大模型智商会降低一些。以这种方式接入 Hermes 并完成多轮调用,目前运行正常——这基本已经是这台机器的极限用法。
关于 QWEN 3.8 27B(稠密模型):
- 在这台设备上已经非常吃力,基础对话也只有约 8~10 Tokens/s。
- 接入 Hermes 后 KV 缓存成倍增长,极易爆内存。
- 尝试过 Q2 版本:体积从 Q4 的约 17GB 降到约 11GB,但速度几乎没有提升(仅增加约 1~2 Tokens),整体依然很慢。
- 结论:该体积的模型在 HX370 上几乎处于不可用状态,想跑这类模型需要上 395 级别、内存更大的机型。
warning 注意 若必须接入 Hermes 等智能体,GPT OSS 20B 是相对均衡的选择:体积相对小、接入速度快、指令遵循能力强,整体要求宽松,效果也可接受,值得一试。
小模型:LFM 2.5 2.6B(Q5)
- 采用 Q5 量化,智商损失比 Q4 更少;追求速度可用 Q4。
- 速度约 35~40 Tokens/s,非常快。
- 指令遵循效果不错,在 Hermes 中调用简单 Skills 或执行命令效果可以。
- 但毕竟只有 2.6B,智商不要期待更多。
各模型速度参考
| 模型 | 类型 | 速度 |
|---|---|---|
| QWEN 3.6 35B A3B | MoE | 约 27 Tokens/s |
| GLM 4.7 Flash | MoE | 约 27 Tokens/s |
| GPT OSS 20B | MoE | 约 27 Tokens/s |
| Ornith 1.5 9B | 稠密 | 约 15~17 Tokens/s |
| LFM 2.5 2.6B(Q5) | 稠密 | 约 35~40 Tokens/s |
MoE 模型速度更快;Ornith 1.5 9B 虽体积不大,但属于稠密模型,速度明显更低。
后续待测试
- AMD Lemonade:可同时调用 GPU 与 NPU,尚未测试。
- AMD 专用 NPU 调用工具FastFlowLM:尚未测试。
- Ling 3.0 Tiny 小模型:本机可跑到 70+ Tokens/s,但尚未在 Hermes 中验证效果,暂不推荐。
小模型测试完成后,会再推荐几款适合配置更低用户的模型。
总结
- 零刻 SER9 Pro(HX370 / 32G / 1TB)整体表现符合预期,使用体验满意。
- 游戏方面:4K 默认设置下可玩丝之歌(约 60 帧)、神秘海域 4(约 47~48 帧);荒野大镖客 2 建议降到 2K。
- AI 方面:纯聊天与 Cherry Studio 场景几乎全部模型可用,基础编程需 9B 以上。
- 接入 OpenClaw / Hermes 等智能体时内存压力剧增,32GB 需将 KV 缓存量化到 Q4 才能稳住。
- 内存是唯一短板,有 AI 需求建议 64GB 起步,或考虑更高阶的 395 平台。
参考视频
零刻HX370小主机游戏和AI表现~3个月后的真实使用分享~