安卓手机运行本地大模型MNN:离线对话与免费API
📺 本图文教程由视频整理而成,对应的参考视频:安卓手机跑AI本地大模型MNN~也能免费提供API和Token~。如需查看更详细、更具体的操作演示,可观看原视频。
场景:手上没有电脑,只有一台安卓手机,也想体验完全跑在本地的 AI 大模型。MNN 是阿里开源的高性能端侧推理框架,安装它提供的安卓客户端后,模型直接运行在手机芯片上,不联网、不消耗 Token,还能对内网其它设备提供 API。
第一步:下载安装包
网盘提供两个文件:官网地址.txt 和已编译好的 APK。官网地址.txt 里是两个 GitHub 链接:
- MNN 项目主页:https://github.com/alibaba/MNN
- APK 下载页:MnnLlmApp 的 Releases 说明
项目主页的 Release 里并没有编译好的安装包,对普通用户来说第二个链接才是关键——页面向下找到 Releases ,点 Download 即可拿到 APK。
第二步:安装并升级到最新版
- 把 APK 传到手机并安装,桌面会出现 MNN 客户端图标。
- 首次打开会提示有新版本,点击下载。
- 按系统提示依次点击「继续安装」→「完成」。
- 重新打开后即为最新版(演示版本 0.8.2.2,MNN 引擎 3.4.1)。
网盘里提供的安装包不是最新版,但装完按提示在线升级即可。
第三步:在模型市场下载模型
打开应用,底部有三个页签:我的模型、模型市场、性能评测。新装的应用里没有模型,先进入「模型市场」。
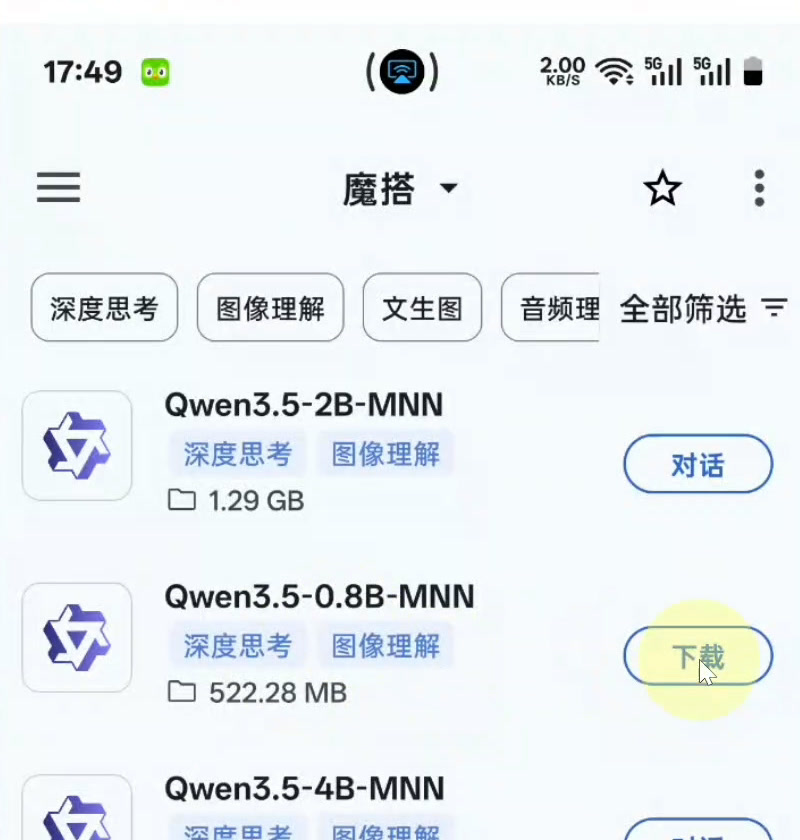
模型市场支持按深度思考、图像理解、文生图、音频理解筛选。列表里每个模型都标注了体积,按手机性能选择即可:
| 模型 | 体积 | 说明 |
|---|---|---|
| Qwen3.5-0.8B-MNN | 522.28 MB | 体积最小、速度最快,适合简单问答和指令控制 |
| Qwen3.5-2B-MNN | 1.29 GB | 速度与效果平衡,主流机型首选 |
| Qwen3.5-4B-MNN | 2.65 GB | 效果更好,但发热明显、速度下降 |
以演示用的骁龙 8+ 为例:2B 能跑到约 15 Tokens/s,4B 只有约 6 Tokens/s,而且发热严重。所以这台设备上 2B 是最合适的尺寸,4B 属于「能跑但不实用」。
第四步:加载模型开始对话
- 回到「我的模型」,已下载的模型会列在这里。
- 双击模型,等待加载完成(2B 通常几秒钟)。
- 在输入框提问,例如「你是谁」,点发送。
回复下方会显示两行速度数据:
- Prefill:提示词处理速度,决定首字延迟。
- Decode:真正的输出速度,演示中为 15.56 Tokens/s。
一般人的阅读速度约为 13 Tokens/s,15 Tokens/s 已经超过阅读速度,日常对话完全够用。小尺寸模型也不代表「智商不够」:视频里 2B 模型写七言绝句,第一次不押韵,指出问题后第二次的成品在意境和押韵上都很不错。0.8B / 2B 这类模型用来做家电控制、简单问答绰绰有余。
第五步:配置 API 服务
MNN 还能把手机上的模型以 API 形式开放给局域网内的其它程序调用。先打开一个模型进入会话,再点右上角的三个点 →「API 设置」。
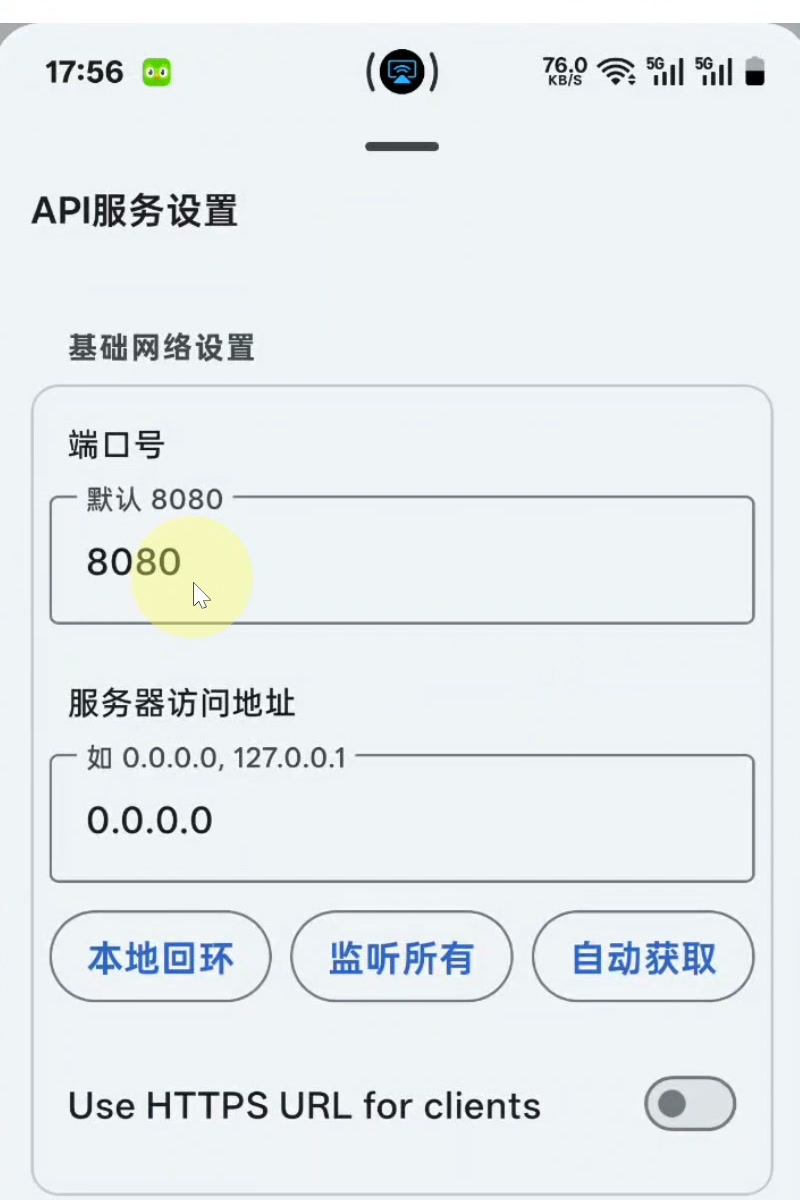
- 端口号:默认 8080,一般不用改。
- 服务器访问地址:默认是本地环回
127.0.0.1,此时只有手机自己能访问。改成0.0.0.0,或直接点「监听所有」,局域网内其它设备才能连上。 - 启用 CORS:调用方是网页类应用时需要打开,否则浏览器会拦截跨域请求。
- 启用 API Key 验证(可选):不设密码也能用;希望安全一点就打开并填入自己设定的 Key。
- 点击「完成」保存。
注意
访问地址保持默认的 127.0.0.1 是新手最常踩的坑——别的设备始终连不上,原因就是它只监听了本机回环地址。
第六步:开启 API 网络服务并调用
退出模型会话,回到主界面,点右上角三个点 →「设置」,在「API 设置」里打开「开启API网络服务」。
之后在其它程序里填写手机的内网地址即可,格式为 http://手机IP:8080;程序若要求 OpenAI 兼容格式,Base URL 填 http://手机IP:8080/v1,模型名选择 Qwen3.5-2B-MNN 这类列表中的名称。设置过 API Key 的,同时在密钥栏填入刚才的密码。
如果不知道手机 IP,在手机的 WLAN 详情里查看。
注意
这个 API 的可用性有限,使用前先了解三点:
- 必须停留在模型会话页面,其它程序才能调用;退出会话就断开。
- 屏幕不能熄灭,还要把应用设为后台不休眠,整体功耗会明显上升。
- 稳定性一般。演示的骁龙 8+ 开启 2B 的 API 会偶发假死,开启 4B 基本无法调用,进入会话都可能失败。
因此它更适合尝鲜和轻量自动化,不适合当作长期在线的服务端。
总结
MNN 把本地大模型真正装进了手机:模型离线运行、不花 Token、数据不出设备。日常使用选 0.8B 或 2B 就够,速度能超过人的阅读速度;4B 以上更适合性能更强的新机型。API 功能可以把手机变成局域网里的免费模型服务,但要接受更大功耗和偶发不稳定的限制。
参考视频
安卓手机跑AI本地大模型MNN~也能免费提供API和Token~